

Еще недавно работа селекционера каннабиса строилась вокруг визуальной оценки, лабораторных тестов и многолетнего накопления опыта. Растения сравнивались по форме куста, структуре междоузлий, плотности соцветий, срокам цветения и результатам анализа ТГК и КБД. Решения принимались на основе наблюдений за несколькими циклами выращивания и стабильности признаков в повторных тестах. Этот подход остается основой и сегодня, поскольку именно он позволяет подтвердить реальную ценность линии в практических условиях.
Однако к традиционной схеме добавился новый фактор — объем данных. Современные программы генотипирования дают подробную картину вариаций ДНК. Лаборатории проводят расширенный химический анализ с учетом минорных каннабиноидов и терпенов. В журналах выращивания фиксируются параметры микроклимата, спектр и интенсивность освещения, режим питания, показатели урожайности и устойчивости к стрессам. Каждая линия сопровождается множеством количественных характеристик. Когда таких линий десятки или сотни, сопоставление всех переменных вручную становится затруднительным и повышает риск упустить важные закономерности.
Здесь и появляется машинное обучение. Это инструмент обработки больших массивов информации, который помогает структурировать данные и выявлять устойчивые связи между генетическими маркерами, условиями выращивания и конечным химическим профилем. Он не подменяет практический опыт селекционера, но делает анализ более системным и количественно обоснованным.
Как данные о ДНК превращаются в прогноз
Синтез каннабиноидов определяется работой конкретных генов, кодирующих ферменты каннабиноидного пути. Эти ферменты участвуют в последовательных реакциях, начиная с образования каннабигероловой кислоты и заканчивая формированием ТГКК, КБДК и других соединений. Любые различия в последовательности ДНК, вариации числа копий генов или особенности их регуляции отражаются на конечном соотношении каннабиноидов в соцветиях.
Важно учитывать, что влияние генетики редко сводится к одному участку ДНК. На химический профиль могут одновременно влиять несколько локусов, а также регуляторные элементы, отвечающие за уровень экспрессии. Поэтому для точного анализа требуется комплексный подход, охватывающий значительную часть генома.
Современные методы секвенирования позволяют получать подробную карту генетических вариаций растения, включая однонуклеотидные замены и структурные перестройки. Параллельно лаборатории определяют точные концентрации каннабиноидов с помощью высокоэффективной жидкостной хроматографии и масс-спектрометрии. Таким образом формируются две взаимодополняющие базы данных: генетическая и химическая.
Машинное обучение связывает эти два уровня информации. Алгоритм анализирует, какие комбинации генетических вариантов чаще встречаются у растений с определенным профилем ТГК, КБД или минорных соединений. Он оценивает вклад каждого маркера в итоговый результат и формирует статистическую модель. На основе этой модели можно рассчитать вероятность того, что конкретный сеянец разовьет заданный химический состав еще до начала цветения.
Для селекционера это означает сокращение времени отбора и более рациональное использование ресурсов. Не все растения необходимо доводить до полного цикла и направлять на лабораторный анализ. Часть можно отсеять на раннем этапе, если их генетический профиль с высокой вероятностью не соответствует поставленной цели.
Работа с редкими соединениями
Интерес к минорным каннабиноидам растет по мере расширения аналитических возможностей. Некоторые из этих соединений присутствуют в очень низких концентрациях, и их выявление стало возможным благодаря более чувствительным приборам и усовершенствованным протоколам анализа.
Проблема заключается в том, что такие профили встречаются редко и часто распределены неравномерно в коллекциях. При анализе сотен или тысяч образцов поиск нестандартных комбинаций вручную становится неэффективным. Алгоритмы машинного обучения помогают ранжировать линии по вероятности наличия редких сочетаний признаков, сокращая объем образцов для дальнейшей проверки.
В расчет включаются генетические данные, вариации числа копий генов, показатели экспрессии и результаты метаболического анализа. Модель оценивает отклонения от типичных профилей и выделяет потенциально перспективные экземпляры. После цифрового отбора кандидаты проходят повторную лабораторную проверку, что позволяет подтвердить стабильность и воспроизводимость выявленного признака в разных условиях выращивания.
Почему важно учитывать условия выращивания
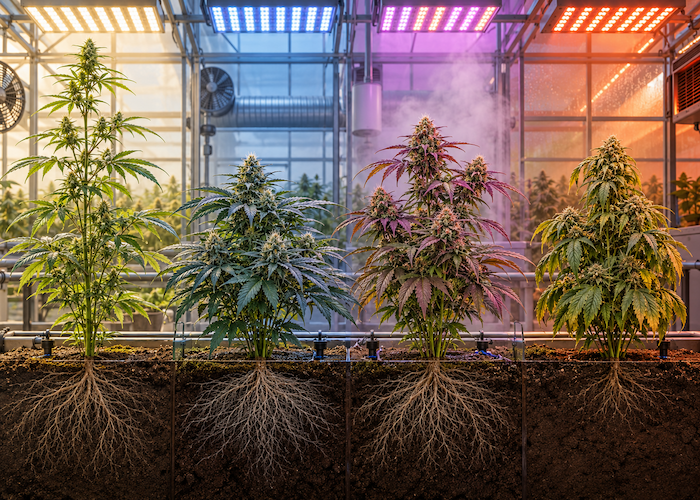
Каннабис отличается выраженной фенотипической пластичностью. Один и тот же генотип способен демонстрировать разные уровни каннабиноидов, терпенов и даже различную морфологию при изменении освещения, температуры, влажности или схемы питания. В закрытых системах влияние оказывает спектр и интенсивность света, фотопериод и плотность посадки. В открытом грунте добавляются колебания температуры, осадки и характеристики почвы.
Такая зависимость от среды усложняет интерпретацию результатов. Если не учитывать параметры выращивания, можно ошибочно приписать изменение химического профиля исключительно генетике. На практике часть вариаций обусловлена микроклиматом или агротехникой.
Поэтому современные предиктивные модели включают не только генетические данные, но и параметры среды. В анализ добавляются сведения о температуре и влажности воздуха, интенсивности и спектре освещения, составе субстрата, режиме полива и питании. Эти переменные позволяют статистически разделить вклад наследственности и условий. В результате прогноз становится более точным и воспроизводимым.
Особенно важен учет среды при оценке устойчивости к стрессам. Толерантность к повышенной влажности, засухе или температурным перепадам проявляется только при наличии соответствующих нагрузок. Если испытания проводятся в стабильных условиях, реальная устойчивость может остаться невыявленной. Алгоритмы сопоставляют данные тепличных и полевых тестов, анализируют реакцию растения на конкретные стрессовые факторы и выявляют закономерности между генотипом и адаптивной способностью.
Проектирование гибридов
Машинное обучение применяется и на этапе планирования скрещиваний. Генетическая дистанция между родительскими формами, распределение аллелей и установленные связи между маркерами и признаками позволяют рассчитать вероятностную картину потомства.
В модель включаются данные о химическом профиле, сроках цветения, структуре кроны и устойчивости к стрессам. На основе этих параметров оценивается диапазон возможных фенотипов в первом поколении и вероятность закрепления признаков в последующих циклах отбора.
Модель не предсказывает точный результат, поскольку наследование количественных признаков остается вариативным. Однако она показывает вероятностное распределение характеристик, что помогает сократить число случайных комбинаций. Селекционная программа становится более рациональной, а ресурсы распределяются с учетом расчетных сценариев, а не только эмпирического опыта.
Требования и ограничения
Точность прогнозов напрямую зависит от качества исходных данных. Для корректной работы моделей необходимы единые протоколы секвенирования, сопоставимая глубина покрытия генома и прозрачные критерии фильтрации полиморфизмов. Аналогично, химический анализ должен выполняться по стандартизированной методике с контролем калибровки оборудования и повторяемости измерений. Даже небольшие различия в протоколах способны приводить к статистическим искажениям.
Не менее важна аккуратная фиксация условий выращивания. Температура, влажность, спектр и интенсивность света, режим питания и состав субстрата должны быть задокументированы с достаточной детализацией. Без учета этих параметров модель может приписывать генетике то, что фактически связано с микроклиматом или агротехникой.
Каннабис сравнительно недавно стал объектом масштабных геномных исследований. В отличие от зерновых культур или овощных видов, объем общедоступных баз данных пока ограничен. По мере накопления репрезентативных выборок, включающих разнообразные линии и разные условия выращивания, модели становятся устойчивее и точнее. Расширение и стандартизация баз данных является ключевым условием дальнейшего развития цифровой селекции.
При этом важно понимать, что алгоритмы выявляют статистические связи между переменными. Они показывают, какие комбинации признаков встречаются вместе чаще всего, но не объясняют механизм на уровне биохимии или физиологии. Биологическая интерпретация остается задачей специалиста, который оценивает результаты с учетом знаний о метаболических путях и наследовании признаков.
Машинное обучение чувствительно к объему и структуре выборки. При недостатке данных возрастает риск переобучения, когда модель хорошо описывает обучающую коллекцию, но теряет точность при переносе на другую популяцию. Генетическая неоднородность линий также может снижать переносимость алгоритмов. Поэтому модели требуют регулярной проверки на независимых наборах данных и обновления по мере накопления новой информации.
Заключение
ИИ в селекции каннабиса представляет собой инструмент системного анализа больших биологических массивов. Он объединяет генетические маркеры, результаты химического анализа и данные о среде в единую структуру оценки, где каждый фактор рассматривается в контексте других.
При достаточном объеме качественных и стандартизированных данных такие модели позволяют ускорить первичный отбор, повысить точность прогноза химического состава и более осознанно планировать гибридизацию. Селекционный процесс становится более управляемым и основанным на количественном анализе, при сохранении ключевой роли специалиста в интерпретации результатов и принятии окончательных решений.
Источники:
- Najafabadi, M. Y. (2025). Machine learning-enhanced multi-trait genomic prediction for optimizing cannabinoid profiles in Cannabis sativa. The Plant Journal.
- Houston, A. (2025, December 10). Marijuana breeders can use AI to design new strains, study demonstrates. Marijuana Moment.
- Çay, T. (2024). Prediction of THC levels in Cannabis species using machine learning methods. Bozok Journal of Agriculture and Natural Sciences, 3(2), 125–136.
